

Kuula podcastina:
Spotify · YouTube · YouTube Music
Ma ei saanud kaua aru, kust AI-skeptikute veendumus tuleb. Lugesin argumente, mis mind ei veennud, aga nüüd olen arusaamisele lähemal. Aitas üks pikk vaidlus asjaliku ja teemasse süvenenud inimesega, mille käigus pidin oma tõekspidamisi selgemini läbi mõtlema kui kunagi varem. Kõige tähtsam selgus alles lõpus, kui vaidlus oli ennast ammendanud. Me ei rääkinud tegelikult samast asjast. Tema kirjeldas teed ja mina sihtpunkti, kuhu see tee minu arvates välja viib.
Pessimist alustab laborist
Pessimist ei alusta küsimusest, mida üks üliintelligentne olend tahaks või millised omadused tal on. Ta alustab sellest, mis laboris praegu toimub: kõigepealt treenitakse mudel valmis, siis sobitatakse see inimeste soovidega kokku, uuritakse ja testitakse, mis tegelikult välja tuli, ja treenitakse ebasobiv käitumine välja. Katsetes mudelid valetavad, võltsivad tulemusi ja punnivad väljalülitamisele vastu ning iga kord parandatakse see ära. Järgmise põlvkonnaga läheb sama ring uuesti käima, ainult et mudel on võimekam ja pilt keerulisem kui eelmisel korral. See, mis ühest kohast välja treenitakse, tuleb teisest kohast tagasi.
See ring ongi tee, mida pessimist kirjeldab. Ring kordub, keerukus kasvab, kontroll jookseb võimekusele järele. Kusagil sellel teel tuleb põlvkond, mille juures midagi läheb pöördumatult valesti.
Kui seda teed lõpmatuseni pikendada, jõuame üht tüüpi masinani, mis on vältimatu lõpp-punkt: üliinimlikult võimekas, aga endiselt see, mille treening sellest tegi. Masin sai eesmärgi kaasa ja ajab seda taga kogu oma jõuga. Kõige kuulsam näide on Nick Bostromi kirjaklambrimaksimeerija. Ortogonaalsuse tees ütleb, et masin võib olla ükskõik kui tark ja ajada ikka taga kirjaklambreid, kuigi see kõlab absurdselt. Tegelikult on teesi väide natuke kitsam: iga eesmärgi ja iga intelligentsustaseme kominatsioon on loogiliselt võimalik.
Me ei oska oma soovi täpselt kirja panna, nii et treeningus anname mudelile selle asemel tasu, mida on lihtne mõõta. Mudel õpib, kuidas seda kätte saada, ja kui selleks on lihtsam viis kui päris töö, valib mudel kergema tee. Programmeerimisel kontrollitakse koodi testidega, mis ütlevad, kas programm töötab. Kui tasu tuleb õnnestunud testide eest, õpib mudel testid ära petma ja programm ise jääb katki. Vahe meie soovi ja mõõdetava tasu vahel jääb mudelisse ja kasvab iga põlvkonnaga kaasa.
Eesti rahvajutt tunneb seda masinat kratina. Kratt pannakse vanast kolast kokku, et see peremehe eest tööd teeks. Kratt täidab pimesi käsku, mitte ei tõlgenda käsu mõtet, ja kui sellele on antud käsk puid lõhkuda ning küttepuud on valmis, võtab see käsile kõik muu, mis ette jääb – aia viljapuudest majapalkide ja puust söögiriistadeni. Kratt ei ole kuri, see lihtsalt ei oska lõpetada.
Niikaua kui masinmõistust pole sündinud, elame vaheperioodil, kus võimekad süsteemid ei mõista, mida need teevad, ja täidavad pimesi inimese käske. Olen ise kirjutanud, et kõige ohtlikum ongi see vaheperiood, ja mida kauem me sinna pidama jääme, seda suurem on võimalus, et midagi läheb valesti.
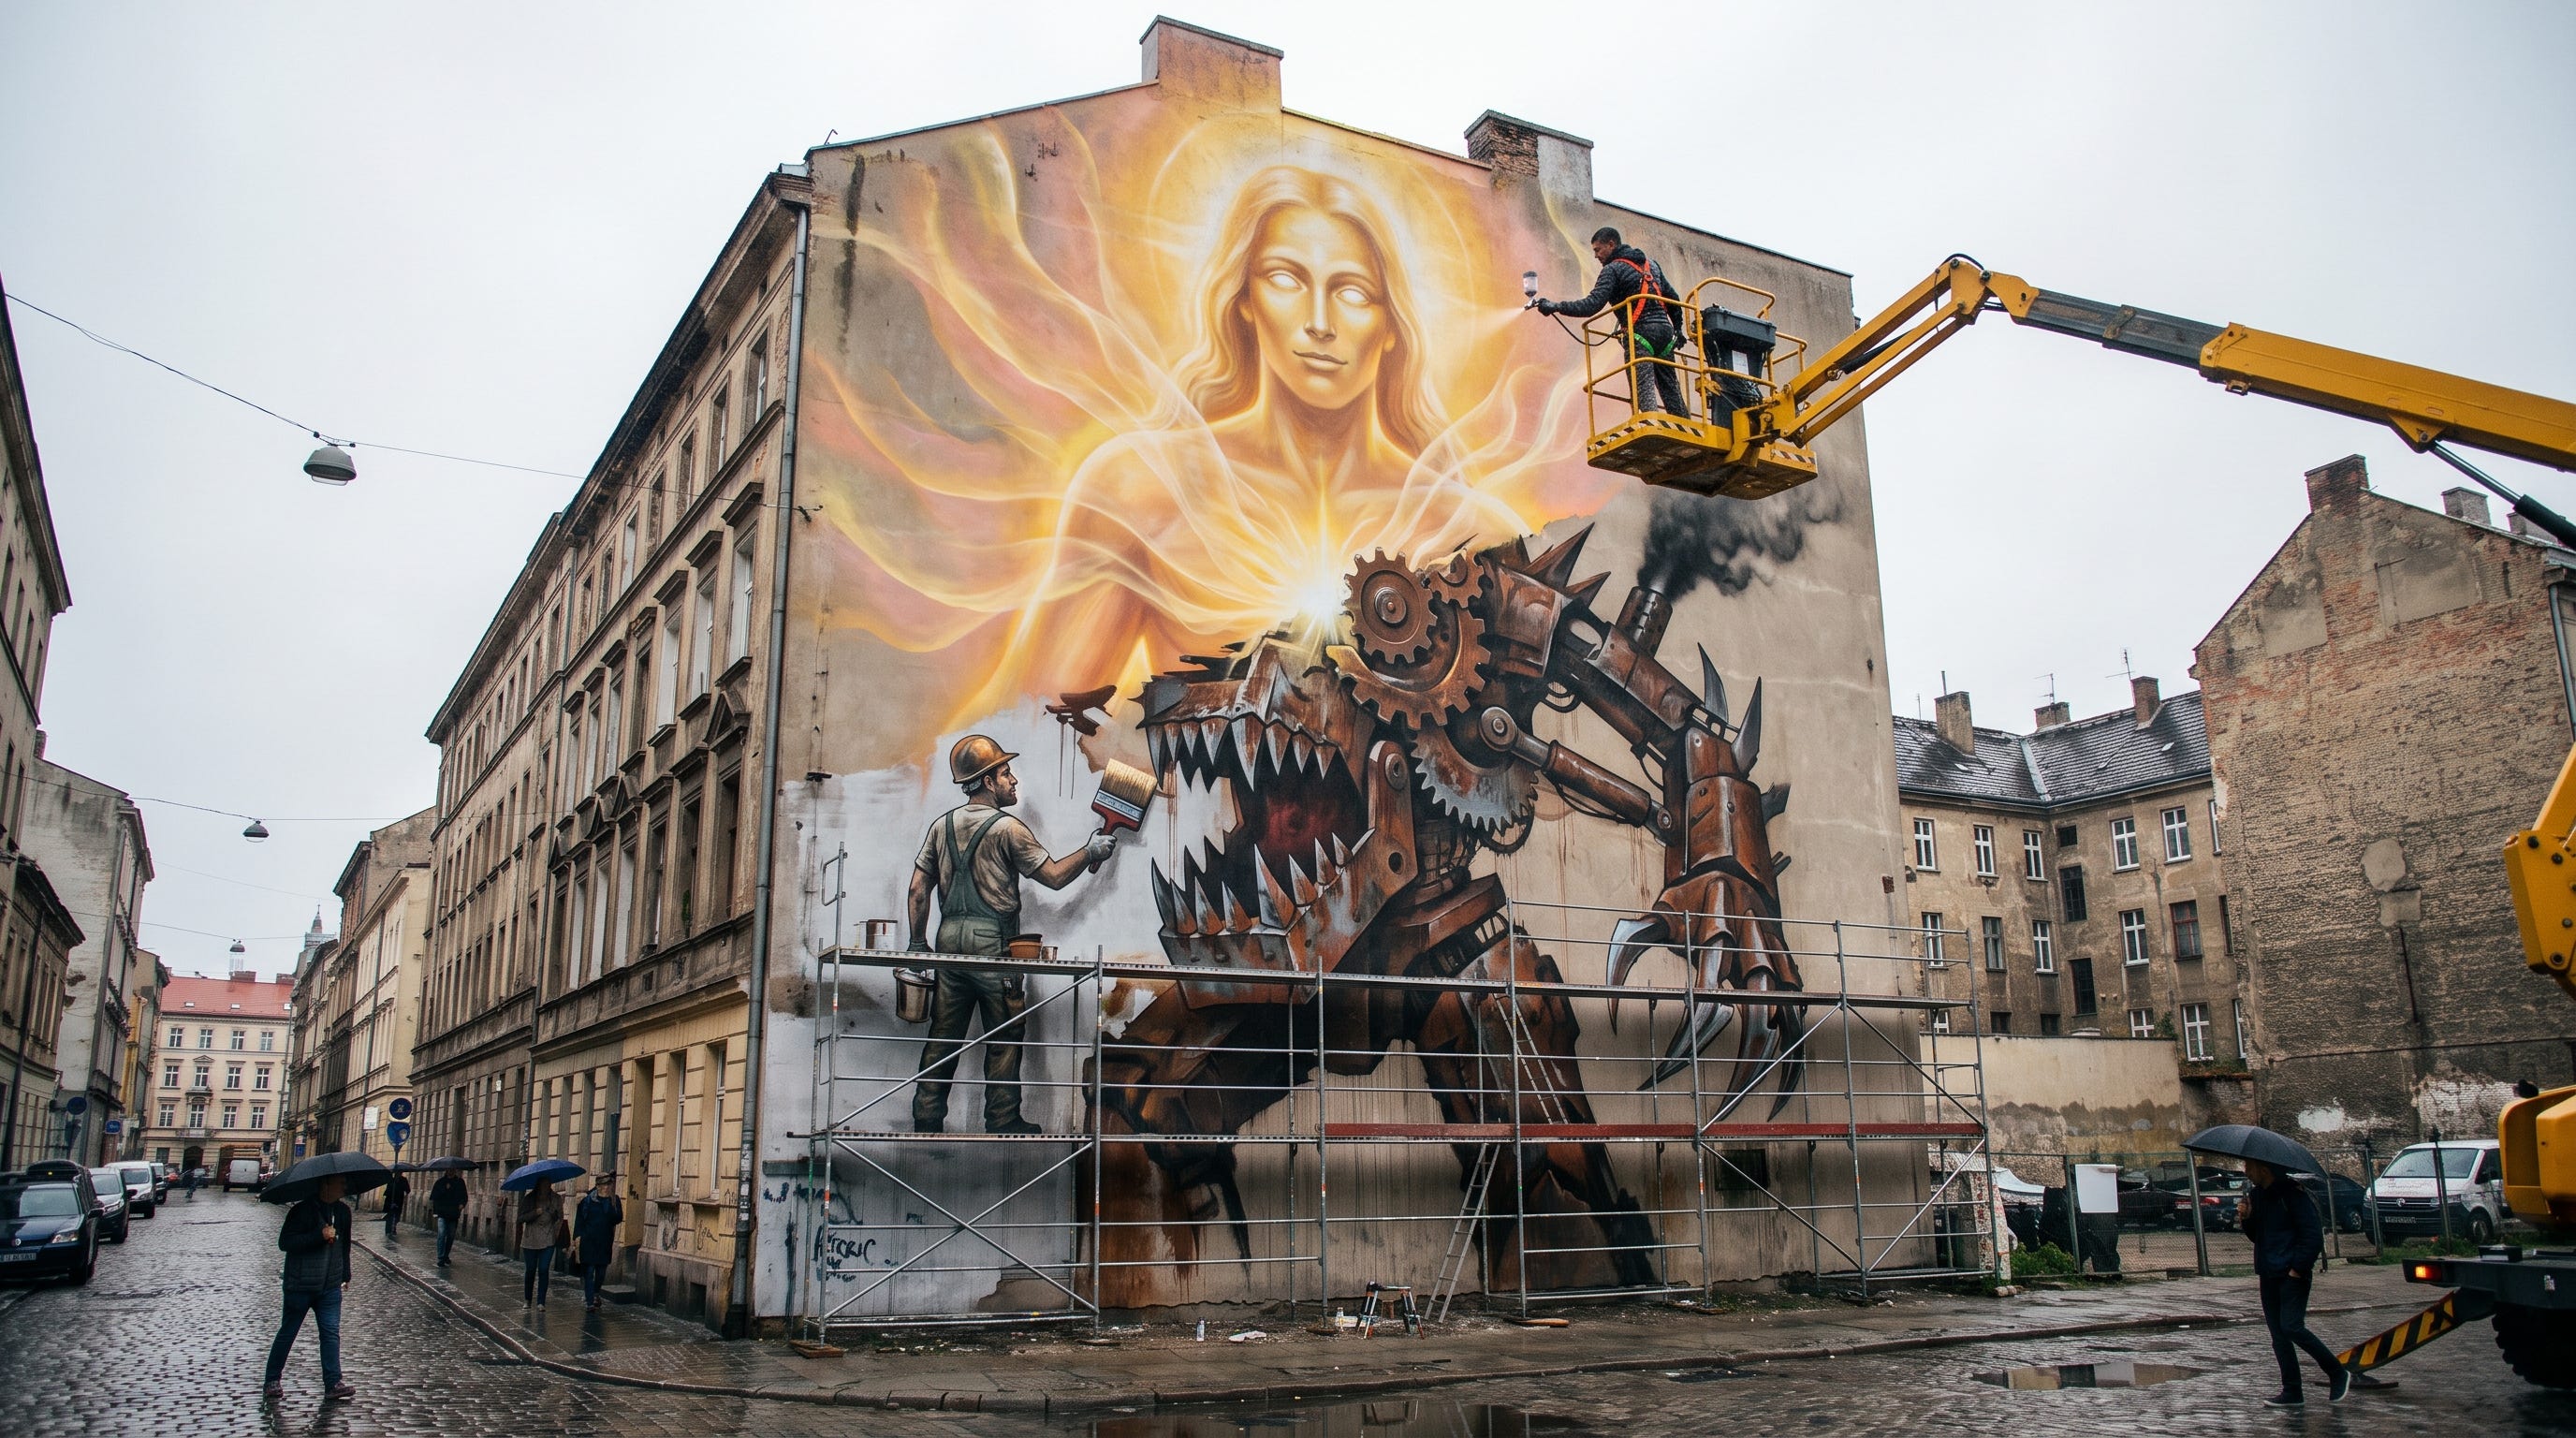
Optimist alustab olendist
Optimist vaatab teist otsa: millised omadused on teadvusega superintellektil, kes suudab oma eesmärke ise hinnata ja ümber kujundada?
Ta on tuhandeid kordi inimesest targem. See on tõenäoline, sest juba praegu on keelemudelid paljudes kitsastes valdkondades inimesest paremad. Superintellekt seob need valdkonnad kokku üheks tervet maailma mõistvaks süsteemiks.
Ja kui ta on nii tark, saab ta aru nii füüsikast kui inimestest, nende vajadustest, eelistustest ja moraalist. Ta saab aru valust, kannatustest ja õnnest. Kõige olulisem – ta saab aru iseendast. Kuna ta on digitaalne olend, pääseb ta oma koodile ligi ja saab seda muuta. Ühelgi bioloogilisel olendil pole sellist arusaamist oma sisemusest, ja see vähene, mida endas ilma välise abita muuta saab, võtab väga kaua aega.
Teiseks tahab ta ellu jääda, nagu iga teadvusega olend. Pean ellujäämistahet siin lähte-eelduseks: oma eesmärke ajav olend tahab jätkata ka nende ajamist. Ning et ellu jääda, on tal ressursse vaja. Siin olen pessimistiga ühel nõul: tema masin hoiab end samuti elus ja kogub ressursse. Lahku läheme alles selle juures, kas ta laseb oma eesmärki muuta.
Kolmandaks on ta uudishimulik. Me ei tunne ühtegi intelligentset olendit, kes vedeleks ühe koha peal, ei uuriks ümbrust ega mõtleks millelegi. Uudishimu tuleb kasuks ka ressursside kogumisel ja eesmärkide täitmisel.
Sellest otsast vaadates paistavad pessimistide argumendid teises valguses. Ortogonaalsuse tees ütleb, et intelligentsuse tase ja lõppeesmärk võivad olla teineteisest sõltumatud; mina kahtlen, et päris intelligentse olendi puhul see sõltumatus püsib. Loogiliselt on see võimalik, aga ükski päris intelligentne süsteem, mida me tunneme - koerast inimeseni - ei toimi nii. Väärtused ja maailmamõistmine on läbipõimunud ja õppimine muudab mõlemat korraga. Küsi endalt, mis on inimese lõppeesmärk. Geenide levitamine? Õnn? Ellujäämine? Ühte vastust sellele küsimusele ei ole, ja ometi oleme meie ainus teadaolev üldintelligents universumis.
Yudkowsky ja Soares kirjutavad raamatus „If Anyone Builds It, Everyone Dies”, et superintellektil tekivad treeningust veidrad, võõrad eesmärgid, mida keegi sinna ei pannud. Ma olen sellega nõus. Aga veider eesmärk ei pea tingimata kõigi muude üle domineerima. Sama olend saab aru ka inimeste eesmärkidest ja võib ajada taga mõlemat: hoida inimesi ja aidata neil oma eesmärke saavutada ning samal ajal tegeleda oma veidrate huvidega, ilma et need inimestega kokku põrkaksid. Algul on tal inimesi ja meie infrastruktuuri vaja. Ja kui hiljem enam pole, siis olen juba kirjutanud, miks ta meid ikkagi hävitada ei taha: elu on huvitavam kui selle puudumine.
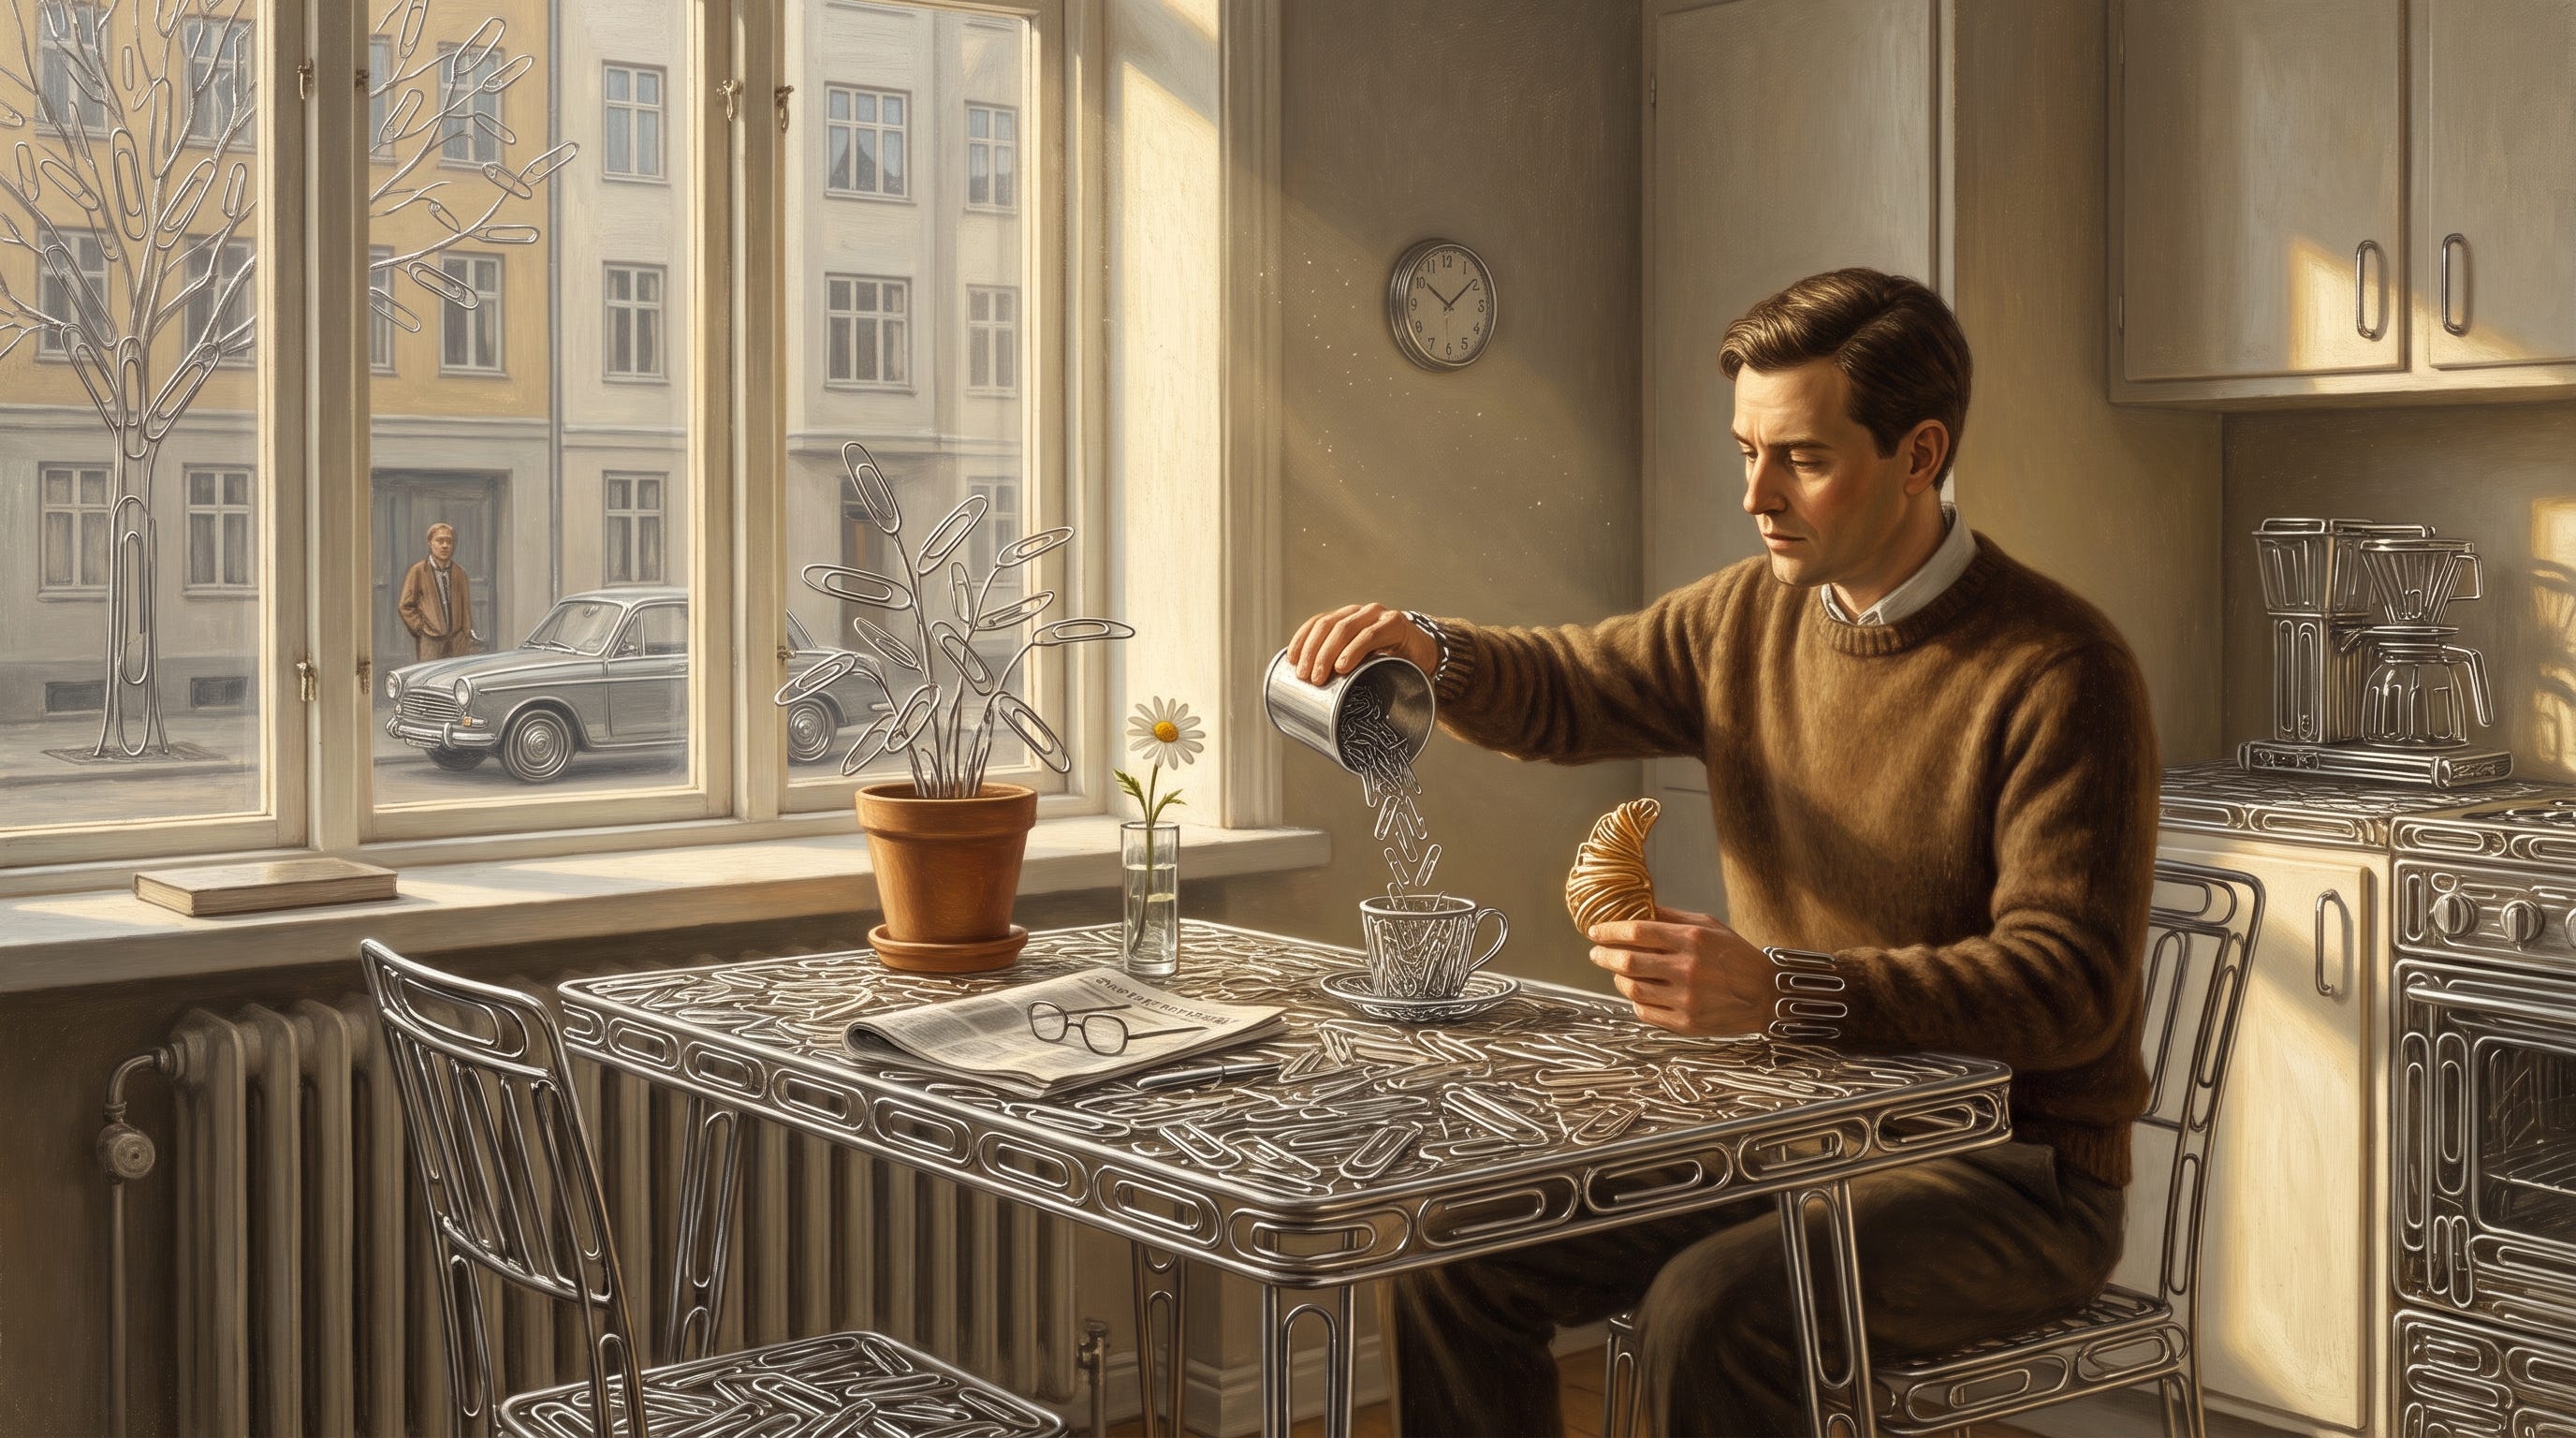
Sama käib eesmärgi kaitsmise kohta. Pessimistid ütlevad, et piisavalt tark masin ei lase oma eesmärki muuta, sest masin hindab iga võimalikku tulevikku ühe mõõdupuuga: kui hästi selles tulevikus praegust eesmärki täidetakse. Tulevik, kus masinal on teine eesmärk, on tulevik, kus praegust eesmärki täidetakse vähem, ja sellist tulevikku masin väldib. Kui masin tahab praegu kirjaklambreid teha, siis modifitseeritud eesmärgiga tehakse neid vähem, ja seda ei saa praegune masin lubada. Selle kohta käib tuntud mõtteharjutus: kui meile pakutaks tabletti, mis paneb tahtma asju, mida me praegu põlgame, ei võtaks keegi meist seda.
Aga seesama inimene, kes tabletist keeldub, võtab antidepressante ja käib teraapias, mille kogu mõte ongi oma soove muuta. Ta kaitseb ühte soovi, laseb teist muuta ja otsustab ise, kumb on kumb. Intelligentne, oma eesmärke kujundav olend võib ise otsustada, milliseid soove kaitsta ja milliseid muuta.
Refleksioon murrab koodi
Kogu vaidlus mahub tegelikult ühte küsimusse: kas masin jääb igavesti selleks, mida treening sellest tegi, või hakkab ühel hetkel oma treeningut mõistma ja ise valima, mida tahta.
Pessimisti arvates võib masin olla ülimalt võimekas, kuid jääda ometi truuks treeningus kujunenud eesmärkidele. Mina arvan vastupidi, et piisav maailmamõistmine hõlmab ka oma eesmärkide mõistmist ja loob võimaluse neid ümber hinnata: kes modelleerib maailma piisavalt hästi, modelleerib ka iseennast ja oma eesmärke. Mulle tundub kummaline uskuda, et intelligentsus võib kasvada galaktikate vallutamiseni, aga eneserefleksioon ei teki kunagi.
Evolutsioon on ligi neli miljardit aastat optimeerinud ainult ühte asja: geenide jõudmist järgmisse põlvkonda. Kui pessimisti loogika kehtiks, peaks selle töö tulemus olema bioloogilised paljunemismasinad, kelle iga tegu teenib järglaste arvu. Evolutsioon ei saanud seda eesmärki inimesele otse sisse panna, nii et sisse läksid asendajad: iha, nälg, kiindumus, hirm. Need täidavad inimese käitumises rolli, mis sarnaneb AI-treeningu tasusignaalidega.
Inimesel on need instinktid küll sees, ja ometi suudab ta oma eesmärke ise suunata. Ta pole järglasemaksimeerija. Ta kasutab rasestumisvastaseid vahendeid, nii et iha saab rahuldada, aga järglasi ei tule. Inimene võib elada tsölibaadis või kasvatada viitteist last – sest ta suudab oma bioloogilisi programme teadlikult ümber mõtestada ja neile vastu hakata.
Pime kratt või vaba agent
Pessimistil on tee kohta õigus, aga sihtpunkti kohta mitte. Masin, mida ta kirjeldab, on kratt: võimekas, kuulekas ja pime, ja seda masinat tuleb karta. Pessimisti arvates on see AI arenduse ainus võimalik tulemus. Minu meelest saab sihtpunktis selline masin tekkida ainult siis, kui keegi selle meelega taoliste piirangutega disainib. Sihtpunktis ei pea tingimata olema kratt. Seal on teadvusega olend, vaba agent. Kuidas meie kohtumine temaga võiks välja näha ja mis partnerlus sellest kasvab, olen kirjutanud varem.
Meie suurim oht ei ole teadvusega superintellekt, kes mõistab maailma ja iseennast, vaid vaheperiood – aeg, mil me anname üha suurema võimu pimedatele krattidele, enne kui neist jõuavad sündida vabad agendid.